[독서노트] - [독서노트]

Added by: 관리자

Updated: Nov 15, 2025, 3:26:50 PM

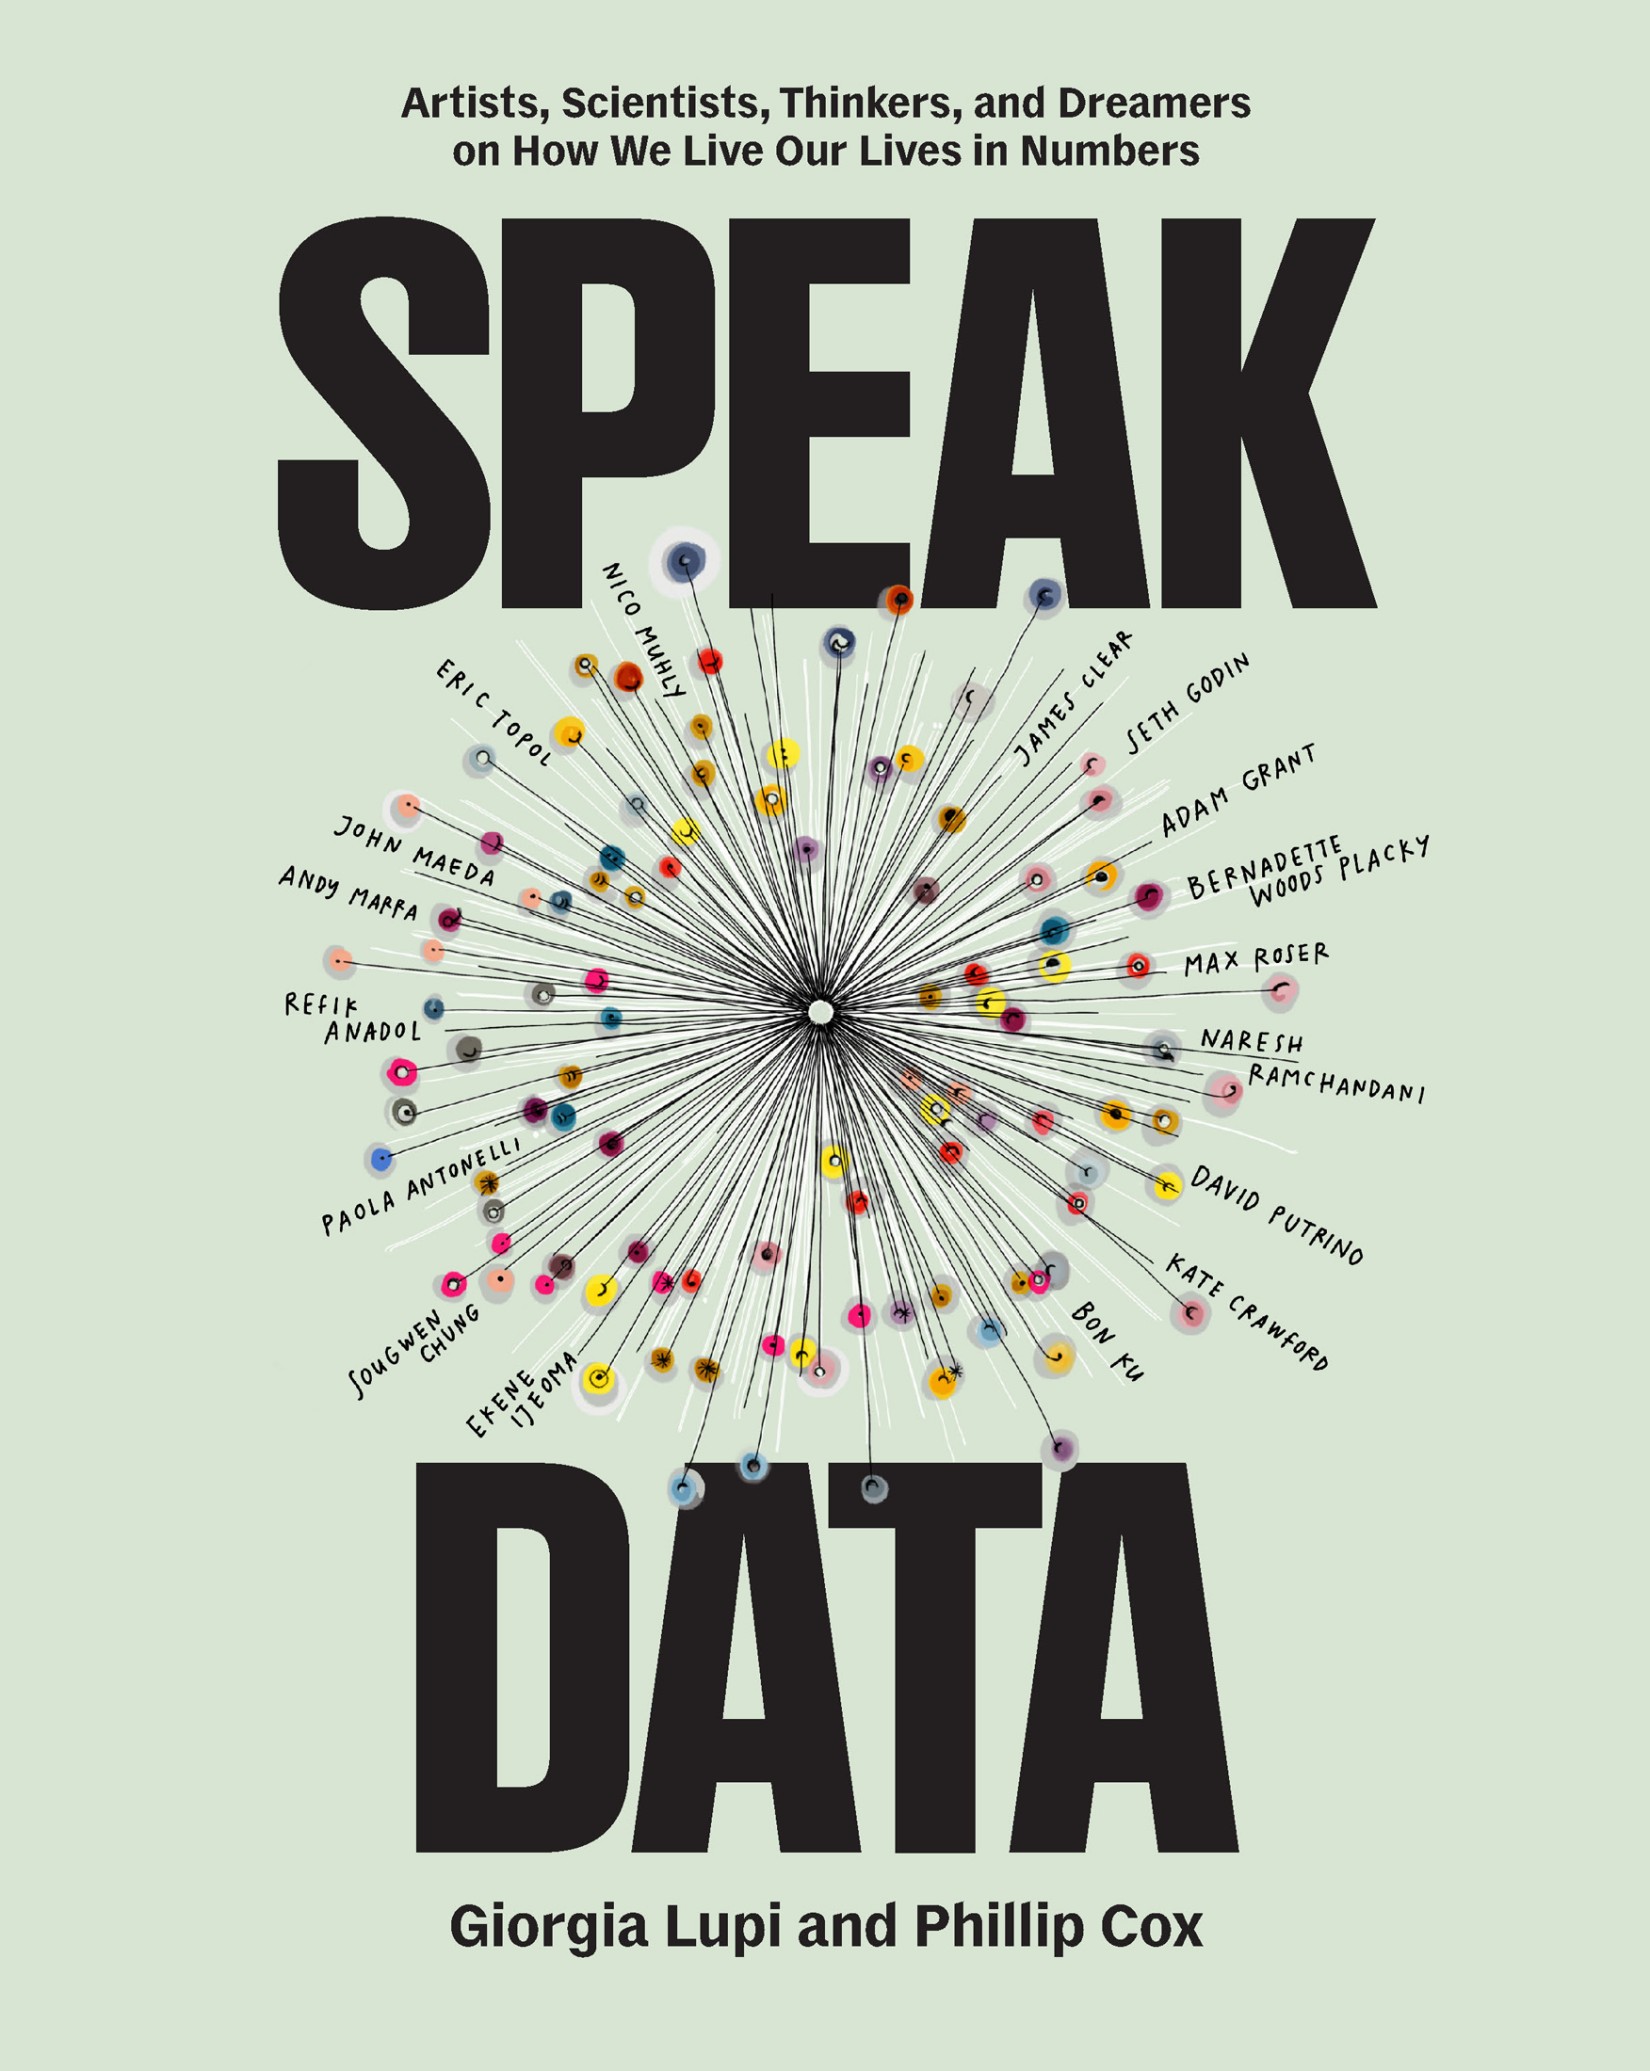
Speak Data - Giorgia Lupi, Phillip Cox

  • 《Speak Data》: 데이터는 어떻게 인간의 언어가 되는가 — 데이터 휴머니즘 심층 비평

  • AI 시대, 숫자를 넘어 인간을 다시 발견하는 법: Speak Data 리뷰

  • 데이터 × 예술 × 인간: 새로운 창의성의 탄생을 보여주는 책

  • 정량화의 시대, 인간을 지키는 언어는 무엇인가? Speak Data가 제시하는 해답

? 서론 | 데이터는 어떻게 인간의 언어가 되는가?

— Speak Data(2025)가 제안하는 ‘데이터 휴머니즘’의 길

21세기 초입에서 데이터는 더 이상 통계 전문가나 기술자들만의 전유물이 아니다. 우리가 날씨를 확인하고, 식단을 기록하고, 지도 앱으로 길을 찾고, 소셜 미디어에서 반응을 주고받는 모든 순간, 데이터는 이미 우리의 일상적 표정과 감정, 습관과 욕망을 은밀하게 기록하고 저장한다. 데이터는 더 이상 단순한 “정보”가 아니라, 우리 시대의 원초적 언어가 되어가고 있다. 그렇다면 우리는 이 새로운 언어를 어떻게 말할 것인가(Speak Data)? 그리고 데이터는 과연 인간의 경험과 감정을 이해하고 표현하는 언어가 될 수 있을까?


? Speak Data: Artists, Scientists, Thinkers, and Dreamers on How We Live Our Lives in Numbers는 이러한 질문을 정면에서 다루는 책이다. Giorgia Lupi와 Phillip Cox는 데이터를 “정확한 과학”으로 보던 기존 관점에서 벗어나, 인간의 삶을 비추는 창이자 새로운 표현 매체로서의 데이터를 탐구한다. 이 책은 과학자·예술가·철학자·활동가 등 17인의 다양한 인터뷰를 중심으로, 데이터와 인간 경험이 교차하는 지점을 포착하며 ‘데이터 휴머니즘(Data Humanism)’의 실체를 선명하게 드러낸다.


? 저자 소개 | Giorgia Lupi & Phillip Cox

— 데이터와 예술, 감성과 과학을 가로지르는 두 사상가

? Giorgia Lupi — “데이터 휴머니즘(Data Humanism)”의 대표적 사상가

Giorgia Lupi는 현대 데이터 시각화 분야에서 가장 독창적인 목소리를 가진 디자이너다. Accurat 공동 설립자이자 Pentagram의 파트너로 활동하며, 데이터에서 인간적 서사를 발굴하는 작업으로 국제적 명성을 얻었다. 그녀의 핵심 철학은 명확하다.


  • 데이터는 세계를 이해하는 프레임(frame)이며

  • 정보를 거르는 필터(filter)이며

  • 인간이 스스로를 표현하는 언어(language)이며

  • 창작의 기반이 되는 재료(material)이다.


그녀의 대표작 Dear Data는 단순한 통계를 넘어 “삶의 질감(texture of life)”을 데이터로 기록하는 새로운 예술적 실험이었다. Lupi는 데이터를 단순한 측정 단위를 넘어, “숫자 뒤에 숨은 맥락의 세계”로 확장시키는 데 큰 역할을 했다.


? Phillip Cox — 음악에서 데이터로 확장된 ‘구조의 감각’

디자이너이자 작가인 Phillip Cox는 음악의 수학적 구조에서 데이터를 발견하며 이 세계에 입문했다. 그에게 데이터는 기능적 도구가 아니라, 아이디어와 감정 같은 비가시적 요소를 소통하게 만드는 창조적 매체이다. 두 저자는 Pentagram에서의 협업을 통해, 데이터를 분석·관리의 대상이 아니라 ‘표현의 도구’로 보게 하는 독특한 관점을 구축해왔다.


? 집필 의도와 주제

— “데이터는 오늘날 가장 강력한 힘이다”

Lupi와 Cox는 이 책의 서두에서 데이터가 오늘날 사회의 “가장 강력한 힘(the most powerful force in society today)”이 되었다고 단언한다. 2023년 기준 인터넷상의 데이터 양은 무려 123 제타바이트에 이르렀으며, 현대인의 삶은 데이터 없이는 설명할 수 없는 구조로 고착되었다.


특히 코로나19 팬데믹은 데이터 의존성의 정점을 드러낸 ‘역사적 충격’이었다. 감염자 수·백신 효과·곡선 평탄화 같은 데이터는 곧 생존의 문제였고, 인류는 데이터 리터러시의 부족으로 “우리는 실패했다”는 직면을 하게 되었다.


따라서 저자들의 문제의식은 명확하다.


데이터의 시대에 인간은 어떻게 데이터를 읽고, 말하고, 해석하고, 표현해야 하는가?


이 질문은 기술적 리터러시가 아니라, 데이터의 인간적 의미—정체성·감정·윤리·창의성—을 사유하는 철학적 질문이다.


? 구성과 전개

— 5가지 인간 경험 영역에서 데이터의 ‘다의성’을 탐구하다

Speak Data는 다음 5개 장을 통해 데이터를 인간 삶의 중심 영역들과 조우시킨다.


  1. Counting Ourselves — 정체성(Identity)
    데이터는 우리를 어떻게 계수하고, 어떤 얼굴을 부여하며, 무엇을 놓치는가?

  2. Making Meaning — 소통(Communication)
    데이터는 어떻게 내러티브가 되고, 감정을 움직이며, 설득의 언어가 되는가?

  3. Vital Signs — 건강(Health)
    의료 데이터는 생명을 어떻게 구하고, 동시에 어떤 새로운 취약성과 불평등을 만드는가?

  4. Machine Thinking — 기술(Technology)
    AI와 알고리즘은 데이터를 통해 새로운 권력 체계를 어떻게 자동화하는가?

  5. Paint by Numbers — 창의성(Creativity)
    데이터는 예술적 표현의 새로운 원료가 될 수 있는가?


각 장은 해당 분야의 사상가들을 인터뷰하며, 데이터의 다층적 의미를 섬세하게 드러낸다.


? 추가 맥락 | 데이터의 모순적 속성

데이터는 다음의 모순된 속성을 동시에 지닌다.


  • 정확하지만(exact) 가변적이며(variable)

  • 유형적이지만(tangible) 추상적이고(abstract)

  • 단수(single) 같지만 복수(plural)의 의미를 품는다


이 모순은 데이터를 ‘사실의 집합’으로 환원할 수 없게 만든다. 데이터는 필연적으로 인간의 선택과 해석을 담은 서사(narrative)이다.


? 핵심 문제의식

Speak Data의 핵심 질문은 다음 한 문장으로 요약된다.


“우리는 어떻게 데이터를 말할 것인가?”


여기서 Speak Data는 ‘데이터를 읽는 법’이 아니라 ‘데이터를 인간의 언어로 번역하는 법’을 묻는다.


  • 데이터는 힘의 환상(illusion of power)을 준다.

  • 모든 것을 정량화하려는 충동은 인간 경험의 질적 층위를 삭제한다.

  • 데이터 포인트는 그 자체로 맥락 없는 순간의 조각이다.

  • “데이터 주도(data-driven)”는 “틀림없는 진실”과 동의어가 될 수 없다.


따라서 Speak Data는 데이터 리터러시를 넘어 데이터 휴머니즘(Data Humanism)을 실천할 것을 요구한다. 즉,


  • 인간이 데이터를 만들었다는 사실을 기억하고

  • 데이터가 담지 못하는 것을 인식하며

  • 데이터의 유용성과 시적 감성 사이의 균형을 찾고

  • 데이터를 수집·해석·표현하는 인간적 책임을 자각하는 것


이것이 데이터를 ‘감시의 도구’가 아닌 “삶의 언어”로 재탄생시키는 길이다.


Chapter 1. Counting Ourselves | 우리 자신을 계수하기 — 데이터와 정체성

✅ 장 개요: 정량화된 자아와 ‘경험의 깊이’ 사이의 간극

Chapter 1은 데이터 시대에 우리가 ‘자신’을 어떻게 이해하고 규정하는지에 대한 가장 근본적인 질문을 제기한다. 저자 Lupi와 Cox는 우리가 일상적으로 사용하는 셀프-트래킹 앱, 소셜 미디어의 좋아요 숫자, 회사에서의 성과 지표 등 거의 모든 데이터가 인간의 정체성을 하나의 ‘수치화된 대상’으로 환원시키는 경향을 비판적으로 분석한다. 정체성은 원래 흐르고 변화하며 복잡하게 엮이는 서사적 존재이지만, 데이터는 그 흐름을 잘라내어 특정 순간의 기록, 즉 하나의 ‘측정 가능한 조각’으로 고정시킨다. 이 장은 바로 그 충돌—인간의 주관적 경험 vs. 데이터를 통한 객관적 표상—을 해부한다. 인간의 자아는 엄격한 객관성의 언어를 빌려 설명될 수 있다는 환상 아래 단순화되며, 데이터가 제공하는 ‘명료성’은 아이러니하게도 우리의 자아를 좁혀놓을 수 있다. 그러나 동시에, 데이터를 통해 우리는 자신의 습관·패턴·감정의 변화를 추적하며 오히려 내면의 구조를 더 정확하게 이해할 수도 있다. Chapter 1은 이 양가적 의미를 섬세하게 풀어내며 데이터와 정체성 사이의 다층적 긴장을 조명한다.


✒️ 핵심 발췌
? “Your identity emerges out of your habits. Every action is a vote for the type of person you wish to become, and the data of your repeated actions over time is the truest reflection of your current identity.” (p. 38)
✍️ “당신의 정체성은 당신의 습관에서 비롯된다. 모든 행동은 당신이 되고자 하는 사람의 유형에 투표하는 것이며, 시간이 지남에 따라 반복된 행동의 데이터는 당신의 현재 정체성에 대한 가장 진실한 반영이다.”
➡️ James Clear는 정체성을 ‘결과’가 아닌 ‘과정’으로 규정하며, 데이터가 우리의 반복적 선택을 기록함으로써 정체성 형성의 흐름을 보여주는 근본적 증거가 될 수 있음을 강조한다.


이처럼 정체성이 행동의 누적 데이터로 설명될 수 있다는 Clear의 관점은 인간을 시간 속에서 변화하는 존재로 파악하는 중요한 시각을 제공하지만, 동시에 데이터는 이러한 흐름 속에서 특정 패턴만을 강조하여 정체성을 협소하게 정의할 위험을 내포한다. 조직 심리학자 Adam Grant는 바로 이 지점—데이터가 정체성을 비추는 ‘거울’이자 동시에 왜곡하는 ‘프레임’이 될 수 있다는 사실—을 날카롭게 파헤친다. Grant는 직장 문화나 사회적 환경에서 사용되는 정량적 지표가 투명성과 객관성을 제공하는 동시에, 인간의 내적 동기·감정·노력 같은 ‘정량화할 수 없는 본질’을 삭제하는 메커니즘을 분석한다.


✒️ 핵심 발췌
? “The problem with purely quantitative measures is they often reward results without capturing the crucial context—the effort, the emotional labor, and the setbacks that truly define a person’s commitment and character.” (p. 42)
✍️ “순전히 정량적인 측정의 문제는 그것들이 종종 결과만을 보상할 뿐, 한 개인의 헌신과 성격을 진정으로 규정하는 결정적인 맥락—노력, 감정 노동, 좌절—을 포착하지 못한다는 점이다.”
➡️ Grant는 데이터가 ‘무엇을 했는지’는 보여주지만 ‘어떻게·왜 했는지’를 삭제함으로써 인간 정체성의 서사적 깊이를 훼손한다고 비판한다.


정체성 데이터의 정치적 측면은 활동가 Andy Marra의 논의에서 극적으로 드러난다. 그는 젠더 정체성, 인종, 성적 지향과 같은 민감한 정체성 데이터가 사회적 인정의 근거가 되는 동시에, 분류·감시·차별의 도구가 되기도 한다는 양가적 현실을 강조한다. 특히 ‘범주(category)’라는 개념 자체가 권력의 산물이라는 통찰은 데이터가 결코 중립적 실체가 아니라는 사실을 명확하게 드러낸다.


✒️ 핵심 발췌
? “For historically erased communities, data is not just numbers; it is recognition. But we must be constantly vigilant about who defines the categories and who controls the data, as classification is always an act of power.” (p. 45)
✍️ “역사적으로 지워진 공동체에게 데이터는 단순한 숫자가 아니다. 그것은 곧 인정이다. 하지만 우리는 누가 그 범주를 정의하고 누가 그 데이터를 통제하는지 끊임없이 경계해야 한다. 분류는 언제나 권력의 행위이기 때문이다.”
➡️ Marra의 시각은 정체성 데이터의 본질이 ‘사실의 기록’이 아니라 ‘권력의 구조화된 시선’임을 보여준다.


Lupi와 Cox는 이 세 인터뷰를 엮으며 데이터가 정체성을 비추는 방식에 존재하는 윤리적 딜레마를 조명한다. 우리는 데이터를 통해 자신을 이해하고자 하지만, 그 순간 데이터는 우리를 특정 조각으로 고정시키며 스스로를 좁게 정의하도록 유도한다. 정체성의 ‘데이터화’는 곧 자기 이해의 확장과 축소라는 모순적 효과를 동시에 만들어낸다. 따라서 저자들은 데이터에 굴복하는 대신, 데이터를 해석하고 활용하는 ‘주체성’을 회복해야 한다고 말한다. 다시 말해, 데이터는 우리 정체성을 규정하는 감옥이 아니라 자기 서사를 직조하는 재료가 되어야 한다.


✨ 해설과 통찰: 데이터 환원주의와 “비-데이터”의 본질

Chapter 1의 핵심 주제는 데이터 환원주의(Data Reductionism)에 대한 비판으로 확장된다. 데이터는 복잡한 인간 경험을 측정·비교·분석 가능한 단위로 단순화하지만, 이 과정에서 ‘정체성의 질적 의미’는 필연적으로 손실된다. 예컨대 행복은 수면 시간, 심박 수, 활동량 등 수치로 표현될 수 있지만, 실제로 우리가 느끼는 행복의 깊이와 의미는 그 어떤 데이터도 온전히 포착할 수 없다. 이는 Max Weber가 말한 ‘탈마법화(disenchantment)’와도 맞닿는다. 과도한 정량화는 인간 경험의 모호함·신비로움·비합리성 같은 중요한 층위를 제거하며, 결국 자아의 풍부함을 희석시킨다. Chapter 1은 ‘데이터가 말해주지 않는 것’을 인식하는 능력이 곧 데이터 시대의 인간성이며, 정체성에 대한 자기 이해에서 중요한 지점임을 강조한다.


? 핵심 요약

  • 정체성은 거대한 사건이 아니라 매일의 작은 행동 데이터의 누적에서 형성된다.

  • 정량 데이터는 투명성과 명료성을 제공하지만 정체성의 질적·맥락적 요소를 삭제할 위험이 있다.

  • 외부 지표(KPI·좋아요·성과)는 인간의 내적 동기와 성격을 왜곡하거나 축소할 수 있다.

  • 민감한 정체성 데이터는 가시성과 인정의 도구이면서 동시에 감시·차별의 도구가 된다.

  • 데이터는 자아를 규정하는 감옥이 아니라 자기 서사를 직조하는 주관적 도구가 될 때 비로소 인간적인 의미를 획득한다.


? 사회적·철학적·심리학적 비교

  • 푸코(Foucault)의 규율 권력: 셀프-트래킹과 성과 측정은 개인이 스스로를 규율하도록 만드는 현대적 판옵티콘이다.

  • 실존주의(Sartre): 인간은 스스로 선택을 통해 정체성을 만든다. 그러나 데이터가 정체성을 ‘고정된 패턴’으로 규정할 때 실존적 자유는 위협받는다.

  • 프레이밍 효과(심리학): 데이터는 그 자체가 아니라 ‘범주화·프레임 방식’이 정체성 인식을 결정한다.


? 연결 독서 제안

✔️ Harari, Homo Deus — 데이터이즘과 정체성의 미래
✔️ Cathy O’Neil, Weapons of Math Destruction — 데이터 편향과 차별
✔️ Charles Duhigg, The Power of Habit — 행동 패턴과 정체성의 구조


? 사유를 여는 질문

  1. 당신의 삶에서 데이터가 결코 포착할 수 없는 ‘질적 경험’은 무엇인가?

  2. 소셜 미디어의 숫자(좋아요·팔로워)는 당신의 정체성을 어떻게 조용히 재구성하고 있는가?

  3. 데이터가 정체성의 거울이 될지 감옥이 될지를 결정하는 ‘당신만의 기준’은 무엇인가?


Chapter 2. Making Meaning | 의미를 만드는 언어: 데이터와 소통

✅ 장 개요: 데이터는 어떻게 ‘언어’가 되는가 — 의미·감정·설득의 삼중 구조

Chapter 2는 데이터를 단순한 수치가 아니라 ‘의미를 부여하는 언어’로 바라보는 전환점의 장이다. 저자 Lupi와 Cox는 데이터가 객관적 진실을 담고 있다는 오래된 믿음을 해체하며, 데이터는 언제나 선택(selection), 편집(editing), 해석(framing)을 거친 후에야 세상에 나타난다는 사실을 강조한다. 다시 말해, 데이터는 스스로 말하지 않는다. 데이터는 해석자의 의도, 감정적 맥락, 전달하고자 하는 서사 구조를 통해서만 ‘말하게’ 된다.


이 장은 데이터를 통해 이야기를 만들고, 대중을 설득하고, 감정적 변화를 일으키는 과정, 즉 데이터 커뮤니케이션(data communication)의 본질을 파고든다. 핵심 인터뷰이로 등장하는 Seth Godin, Max Roser, Naresh Ramchandani는 각각 ‘데이터는 이야기다’, ‘데이터는 맥락이다’, ‘데이터는 논증이다’라는 세 가지 축을 구성하며 데이터 소통의 윤리적·정치적 구조를 총체적으로 드러낸다. 이 장은 데이터가 진실을 보여주는 것이 아니라 진실을 구성하는 방식임을 강조한다. 그렇기에 데이터는 강력한 설득의 언어이자, 동시에 위험한 수사적 도구가 된다.


✒️ 핵심 발췌
? “The data doesn’t speak for itself; it speaks through the story we choose to tell about it. We are not just data collectors; we are meaning makers. If the data doesn't move people to feel something or do something, it’s just noise.” (p. 66)
✍️ “데이터는 스스로 말하지 않는다. 우리가 그것에 대해 말하기로 선택한 이야기를 통해 말한다. 우리는 단지 데이터 수집가가 아니다. 우리는 의미를 만드는 사람들이다. 만약 그 데이터가 사람들을 움직이게 하지 못한다면, 그것은 단지 소음에 불과하다.”
➡️ Seth Godin은 데이터의 본질을 ‘스토리텔링’으로 규정하며, 데이터의 가치는 사실 여부가 아니라 행동을 바꾸는 감정적 공명에서 결정된다고 말한다.


Godin의 관점은 데이터가 전달하는 메시지를 정보가 아닌 정서적 설득(emotional persuasion)의 단계로 끌어올린다. 이는 데이터 시각화나 보고서 작성이 기술적 작업이 아니라, 심리적·수사적(act of rhetoric) 과정임을 드러낸다. 즉, 데이터의 핵심 기능은 ‘설명’이 아니라 ‘설득’이다. Lupi와 Cox는 이 지점을 중요하게 다루며, 데이터를 다루는 사람은 숫자의 조합자가 아니라 서사의 구축자(narrative architect)라는 점을 독자에게 환기한다.


이어서 Max Roser는 데이터 소통에서 가장 중요한 원칙은 맥락(context)이라고 강조한다. Roser는 세계 발전 데이터 플랫폼 Our World in Data를 운영하며, 대중이 뉴스나 단편적 숫자에 휘둘리는 이유를 “맥락의 부재”로 진단한다. 사람들은 매일의 불행한 사건의 데이터(범죄, 사고, 재난)에 압도되지만, 역사적 관점에서 보면 인간의 삶은 전반적으로 개선되어 왔다. 따라서 데이터 소통은 단일 숫자를 던지는 것이 아니라, 장기적 스케일·역사적 지평·비교 가능한 프레임 등을 함께 제시할 때 비로소 진실에 가까워진다.


✒️ 핵심 발췌
? “The most responsible way to communicate data is by providing context and scale, especially the historical dimension. Without knowing where we’ve come from, a single data point or a single year’s figure is misleading, leading to unwarranted fear or misplaced hope.” (p. 72)
✍️ “데이터를 소통하는 가장 책임 있는 방식은 맥락과 규모, 특히 역사적 차원을 제공하는 것이다. 우리가 어디에서 왔는지 알지 못하면, 단 하나의 데이터 포인트나 한 해의 수치는 오해를 낳아 불필요한 두려움이나 잘못된 희망으로 이어진다.”
➡️ Roser는 데이터 소통의 핵심을 ‘정직한 맥락화’로 명확히 제시한다. 숫자 자체보다 숫자를 둘러싼 시간·공간·역사적 깊이가 진실을 구성한다는 통찰이다.


Roser의 관점은 데이터의 위험성이 ‘왜곡된 숫자’가 아니라 ‘맥락 없이 제시된 숫자’에서 비롯된다는 점을 상기시킨다. 예컨대 범죄율이 상승한 것처럼 보이는 데이터도 장기적으로 보면 감소 추세일 수 있다. 따라서 데이터 소통자는 언제나 “전체 그림(The Big Picture)”을 보여줄 의무가 있다.


장 후반부에서 디자이너 Naresh Ramchandani는 한층 더 비판적인 시각을 제시한다. 그는 데이터 시각화가 종종 중립성을 가장하지만, 사실은 모두 ‘편집된 이야기’이며, 모든 그래프와 차트에는 특정한 ‘의도’와 ‘이해관계’가 숨어 있다고 경고한다. 데이터를 통해 무엇을 말할 것인지뿐 아니라 무엇을 말하지 않는지도 중요한 윤리적 선택이다.


✒️ 핵심 발췌
? “We have to treat data visualizations and statistics not as evidence itself, but as highly edited and curated statements. Every chart is an argument, a point of view, and we must ask: What is the author trying to sell, and what is the data not showing?” (p. 78)
✍️ “우리는 데이터 시각화와 통계를 그 자체로 증거로 취급할 것이 아니라, 고도로 편집되고 선별된 진술로 다루어야 한다. 모든 차트는 하나의 논증이며 관점이다. 우리는 물어야 한다: 저자는 무엇을 팔려고 하는가, 그리고 데이터는 무엇을 보여주지 않는가?”
➡️ Ramchandani는 데이터의 ‘비가시적 편향’을 드러내며, 독자는 데이터를 보는 순간 반드시 역질문(counter-questioning)을 해야 한다고 말한다.


Lupi와 Cox는 이 세 관점을 연결하며 데이터 소통의 최종 결론을 제시한다. 성공적인 데이터 소통은 기술적 정밀성과 인간적 진정성의 균형을 필요로 한다. 데이터는 ‘정답’을 제시하는 문장이 아니라, ‘대화를 시작하는 초대장’이어야 한다는 것이다. 데이터는 대중을 움직이기 위해 쓰일 수 있지만, 그만큼 신중하고 책임 있는 서사 구성의 철학을 요구한다.


✨ 해설과 통찰: 고대 수사학에서 현대 데이터 레토릭으로

Chapter 2의 핵심은 고대 수사학의 원리—에토스(Ethos), 파토스(Pathos), 로고스(Logos)—가 그대로 데이터 소통에 적용된다는 사실이다. Roser는 로고스(논리)의 대표주자이며, Godin은 데이터의 감정적 울림이라는 파토스(감정)를 강조한다. Ramchandani의 비판은 에토스(신뢰성)의 문제에 해당한다. 이 세 요소가 균형을 잃는 순간, 데이터는 진실을 밝히는 도구가 아니라 선동·왜곡·마케팅의 무기가 된다. 현대 사회에서 데이터는 객관적 진실이 아니라 잘 구성된 ‘수사적 메시지’이므로, 독자는 이를 읽고 해석하는 능력을 갖춰야 한다.


? 핵심 요약

  • 데이터는 스스로 말하지 않으며, 스토리텔링을 통해 의미가 부여되는 서사적 재료이다.

  • 데이터 소통의 핵심은 정확성보다 감정적 공명과 행동 유발에 있다.

  • 책임 있는 데이터 소통은 숫자에 역사적·정치적·사회적 맥락을 제공한다.

  • 모든 데이터 시각화는 논증이며 관점이며, 중립성은 환상이다.

  • 데이터는 ‘정답 제시’가 아니라 ‘대화의 공간’을 여는 인간적 언어가 되어야 한다.


? 사회적·철학적·심리학적 비교

  • 니체(Nietzsche)의 진실 비판: 절대적 진실을 향한 욕망은 권력 의지의 투영이며, 데이터의 객관성 신화도 동일한 구조를 가진다.

  • 보드리야르(Baudrillard)의 시뮬라크르: 데이터는 실제보다 더 실제처럼 보이는 ‘과잉 현실’을 만들 수 있다.

  • 인지심리학의 앵커링 효과: 초기에 제시된 데이터 프레임이 모든 판단을 좌우한다.


? 연결 독서 제안

✔️ Daniel Kahneman, Thinking, Fast and Slow — 데이터 프레임과 편향
✔️ Edward Tufte, The Visual Display of Quantitative Information — 데이터 시각화 윤리
✔️ Scott Peck, The Road Less Traveled — 진정성·현실 직시의 가치


? 사유를 여는 질문

  1. 당신이 최근 본 데이터 시각화 중 가장 설득력이 강했던 것은 무엇이며, 그 ‘감정적 힘’은 어떤 방식으로 구성되어 있었는가?

  2. 숫자가 ‘사실’처럼 보이는 시대에, 당신은 어떤 기준으로 데이터의 맥락을 재구성하며 비판적으로 읽을 수 있는가?

  3. 데이터가 대화를 열기보다는 닫아버리는 순간은 언제인가? 그 경계를 어떻게 감지할 수 있는가?


Chapter 3. Vital Signs | 생명 신호: 의료 데이터의 힘과 취약성

✅ 장 개요: 실시간 데이터의 약속과 생체 정치학의 그림자

Chapter 3은 팬데믹 시대 이후 가장 급진적으로 변화한 영역, 즉 건강(Health)과 의료(Medicine) 분야에서 데이터가 수행하는 역할을 분석한다. 건강 데이터는 단순한 의학적 정보가 아니라 생명을 구조하는 ‘바이탈 사인(vital sign)’이자, 동시에 인간의 취약성을 노출시키는 ‘감시의 신호’가 될 수 있다. 이 장의 핵심 논지는 의료 데이터가 정확성·효율성·실시간성이라는 기술적 약속을 제공하는 동시에, 신뢰·투명성·불평등이라는 인간적 질문을 불러일으킨다는 사실이다.


저자 Lupi와 Cox는 의료 데이터를 둘러싼 이중 구조—구원과 위험, 통제와 종속, 자율성과 감시—를 인터뷰이를 통해 입체적으로 탐구한다. 특히 David Putrino는 데이터의 가능성을, Eric Topol은 데이터가 초래하는 신뢰 문제를, Ijeoma Ekene은 사회적 편향을 통해 의료 데이터가 가진 구조적 위험을 강조한다. Chapter 3은 결국 “건강 데이터는 누구의 생명을 가장 먼저 구하고, 누구의 생명을 가장 나중에 구하는가?”라는 질문으로 귀결된다.


✒️ 핵심 발췌
? “For too long, healthcare has been a reactive process based on generalized assumptions. Real-time, continuous data empowers the patient, shifting the dynamic from the doctor telling the patient what’s wrong, to the patient co-authoring their own health narrative based on verifiable data.” (p. 110)
✍️ “너무 오랫동안 의료는 일반화된 가정에 기반한 사후 반응적 과정이었다. 실시간, 연속적 데이터는 환자에게 권한을 부여하며, 의사가 환자에게 무엇이 잘못되었는지 말하던 방식에서 벗어나 환자가 검증 가능한 데이터를 기반으로 자신의 건강 서사를 공동 집필하도록 만든다.”
➡️ Putrino는 데이터가 ‘환자의 자율성’을 강화하여 건강 관리를 사후적 진단에서 선제적 예방으로 전환시키는 구조적 변화를 설명한다.


Putrino의 관점은 의료 데이터가 환자 중심의 패러다임을 촉진하는 긍정적 효과를 명확히 보여준다. 스마트워치, 웨어러블 센서, 원격 모니터링은 환자에게 자신의 컨디션을 실시간으로 평가할 수 있는 능력을 부여하고, 이를 통해 의료 전문가와의 권력 관계를 재구성한다. 그러나 이 변화는 기술적 효율성만으로 설명될 수 없다. 왜냐하면 의료 데이터의 증가가 곧바로 의료적 신뢰의 증가로 이어지지 않기 때문이다.


이 지점에서 심장 전문의 Eric Topol의 경고는 결정적이다. 그는 AI 진단이 가져오는 높은 정확도에도 불구하고, 의료 행위에서 가장 중요한 요소는 진실성·설명 가능성·신뢰라고 말한다. 특히 AI의 ‘블랙박스’ 문제는 의료 데이터가 아무리 기술적으로 정교하더라도, 의료인이 그 결과를 설명할 수 없다면 환자 경험은 오히려 불안을 증폭시키게 된다고 지적한다.


✒️ 핵심 발췌
? “The most crucial vital sign in the age of AI-driven medicine is trust. If a deep learning algorithm suggests a diagnosis, but we cannot explain the data points that led to that conclusion, the human factor of faith in the diagnosis collapses.” (p. 118)
✍️ “AI 기반 의료 시대의 가장 중요한 생명 신호는 신뢰이다. 딥러닝 알고리즘이 진단을 제시하더라도, 그 결론에 도달한 데이터 포인트들을 설명할 수 없다면 진단에 대한 인간적 신뢰는 무너진다.”
➡️ Topol은 의료 데이터의 ‘정확성’보다 ‘설명 가능성’이 더 중요하며, 신뢰가 붕괴할 경우 데이터 중심 의료의 기반이 모두 흔들릴 수 있음을 경고한다.


Topol의 지적은 의료 AI의 본질적 딜레마를 드러낸다. AI는 인간 의사보다 빠르게 패턴을 분석하지만, ‘왜 그렇게 판단했는가’를 설명하지 못하면 환자는 정보가 많아졌음에도 불구하고 오히려 통제력을 상실하는 경험을 하게 된다. 즉, 데이터가 늘어날수록 인간의 불안도 함께 증가하는 역설이 발생한다.


마지막 인터뷰이인 공중보건 전문가 Ijeoma Ekene은 의료 데이터의 가장 깊은 구조적 문제—편향(bias)—을 지적한다. 데이터 세트가 불평등한 사회 구조에서 수집될 경우, 그 데이터가 학습한 AI 역시 구조적 차별을 내장하게 된다. 이는 단순히 ‘부정확한 진단’을 넘어 특정 인구 집단의 생존 가능성을 낮추는 위험한 결과를 초래할 수 있다.


✒️ 핵심 발췌
? “If we digitize a broken system, we don’t fix it; we just make it faster and bigger. Data is not neutral; it is embedded with the history of societal exclusion. When the data doesn't represent marginalized populations, the resulting AI models will inevitably be inaccurate or even harmful to them.” (p. 124)
✍️ “우리가 고장 난 시스템을 디지털화한다면 그것을 고치는 것이 아니다. 단지 더 빠르고 더 크게 만들 뿐이다. 데이터는 중립적이지 않으며 사회적 배제의 역사를 내재한다. 데이터가 소외된 인구를 대표하지 않을 때, 그 결과로 만들어지는 AI 모델은 불가피하게 부정확하거나 그들에게 해로울 것이다.”
➡️ Ekene은 의료 데이터의 ‘포괄성(inclusiveness)’이 기술적 정확도만큼이나 중요하며, 데이터의 공백이 생명·건강 수준의 불평등을 재생산한다는 점을 강조한다.


Lupi와 Cox는 이 세 인터뷰를 연결하며 의료 데이터의 본질적 질문을 제시한다. 기술은 결코 중립적이지 않고, 데이터 역시 저절로 객관적이지 않다. 의료 데이터가 인간의 생명을 진정으로 보호하려면, 환자의 자율성·데이터 과정의 투명성·사회적 포괄성이라는 세 가지 축이 반드시 조화되어야 한다. 그렇지 않을 경우, 건강 데이터는 개인을 구하는 도구가 아니라 특정 집단을 고립시키는 체계로 변할 수 있다.


✨ 해설과 통찰: 생체 정치학(Biopolitics)으로 본 의료 데이터의 권력

Chapter 3의 내용은 Michel Foucault의 생체 정치학 개념과 깊게 연결된다. Foucault에 따르면 현대 권력은 신체를 직접 억압하는 것이 아니라, 인구·건강·생명을 관리하는 방식으로 작동한다. 웨어러블과 AI 건강 모니터링은 개인에게 자유와 통제력을 주는 것처럼 보이지만, 동시에 의료 데이터가 국가·기업·보험사의 새로운 감시 체계로 작동할 여지를 만든다. 즉, 개인은 자신의 건강을 스스로 모니터링함으로써 ‘자기 감시(self-surveillance)’ 체계에 참여하게 된다. 이러한 구조에서 데이터의 주인은 누구인가? 데이터에 접근할 권리는 누구에게 있는가? 데이터 삭제의 권리는 보장되는가? 이러한 질문은 모두 의료 데이터의 정치적 본질을 드러낸다. 데이터가 ‘선제적 치료’라는 명분 아래 개인의 신체를 지속적으로 감시하는 구조는, 건강 데이터가 곧 현대의 권력 장치가 됨을 의미한다.


? 핵심 요약

  • 실시간 건강 데이터는 의료를 사후적 진단에서 선제적 예방으로 전환시킨다.

  • 의료 AI의 가장 중요한 ‘바이탈 사인’은 정확성보다 신뢰이며, 블랙박스 문제는 신뢰를 훼손한다.

  • 의료 데이터는 사회적 배제의 역사를 내포하며, 데이터 공백은 구조적 불평등을 재생산한다.

  • 의료 데이터의 품질은 기술적 요건뿐 아니라 투명성·자율성·포괄성의 윤리적 조건에 달려 있다.

  • 건강 데이터는 생명을 보호하는 수단이자, 동시에 새롭게 구성되는 생체 정치학의 핵심 장치다.


? 사회적·철학적·심리학적 비교

  • 바우만(Bauman)의 액체 근대: 실시간으로 변화하는 건강 데이터는 고정된 진단 개념을 해체하고, 끊임없이 흐르는 ‘액체 건강’을 만든다.

  • 칸트(Kant)의 인간 존엄성: 건강 데이터가 보험·기업의 이윤을 위해 이용될 때 인간은 ‘목적’이 아니라 ‘수단’이 된다.

  • 통제 환상(Illusion of Control, 심리학): 환자가 데이터를 더 많이 얻을수록 실제 통제력은 줄어드는 역설이 발생할 수 있다.


? 연결 독서 제안

✔️ Atul Gawande, Being Mortal — 인간 존엄성과 의료 기술의 끝
✔️ Daniel Dennett, Consciousness Explained — 데이터로 환원되지 않는 인간 경험
✔️ Michelle Huang, The Biopolitics of the Data-Driven Life — 데이터 시대의 권력 구조


? 사유를 여는 질문

  1. 당신의 건강 데이터가 기업·국가·보험사 중 어느 주체에게 가장 큰 권력을 부여하고 있을까?

  2. AI 진단이 설명 불가능하지만 정확도가 99%라면, 당신은 어떤 기준으로 신뢰 여부를 결정할 것인가?

  3. 데이터가 충분히 대표하지 못하는 ‘소수 집단’의 의료 권리는 어떻게 보장될 수 있을까?


Chapter 4. Machine Thinking | 기계적 사고: 데이터와 기술의 권력

✅ 장 개요: 알고리즘의 논리가 인간 사회를 재구성하는 방식

Chapter 4는 데이터 시대의 핵심 구동력, 즉 AI·알고리즘·빅데이터로 대표되는 기술이 우리의 사고방식과 사회 구조를 어떻게 재편하는지 분석한다. 기술은 데이터를 통해 세계를 이해하고 분류하며 관리하는 새로운 ‘사고 체계’를 만들어내는데, 저자 Lupi와 Cox는 이를 “기계적 사고(machine thinking)”라고 명명한다. 기계적 사고는 효율성·정확성·예측 가능성을 약속하는 탓에 매력적이지만, 동시에 세상을 특정 방식으로만 보도록 강제하는 ‘틀 짓기(Enframing)’의 힘을 가진다.


이 장은 AI가 단순한 계산 도구가 아니라 인간 사회에 내재된 권력·편향·역사를 자동화해 강화하는 존재라는 점을 날카롭게 드러낸다. 인터뷰이 Kate Crawford, John Maeda, Refik Anadol은 각각 ‘권력’, ‘해독 가능성’, ‘창조성’이라는 축을 통해 기술과 데이터의 관계를 입체적으로 설명하며, 독자로 하여금 기술의 표면 아래 숨어 있는 철학적·정치적 구조를 다시 보게 만든다.


✒️ 핵심 발췌
? “Artificial intelligence is not a disembodied logic; it is materialized by data and infrastructure, and it operationalizes deep-seated power relations. The data used to train AI models is a historical artifact, a mirror reflecting not the world as it is, but the world as we have structured it, complete with our biases and inequalities.” (p. 142)
✍️ “인공지능은 몸 없는 논리가 아니다. 그것은 데이터와 인프라에 의해 물질화되며, 깊숙이 뿌리내린 권력 관계를 작동시킨다. AI 모델을 훈련하는 데 사용되는 데이터는 역사적 유물이자, 세상을 있는 그대로가 아니라 우리가 구조화해 온 편견과 불평등을 담은 거울이다.”
➡️ Crawford는 AI를 가치 중립적 기술로 보는 환상을 거부하며, 기술이 사회적 권력을 자동화하는 시스템임을 밝힌다.


Crawford의 통찰은 AI의 본질이 ‘지능’이 아니라 ‘자동화된 권력 구조’라는 사실을 강조한다. 알고리즘은 중립적 계산 장치처럼 보이지만, 그 내부에는 과거의 차별·정치적 권력·경제적 이해관계가 그대로 기록되어 있다. AI는 이 역사적 유물을 확장·정교화·가속화함으로써, 인간보다 더 빠르고 더 넓은 규모에서 편향을 실행할 수 있다. 이때 ‘기계적 사고’는 기술이 아니라 사회의 특정 질서를 유지하는 장치가 된다.


다음으로 John Maeda는 기술이 가진 복잡성이 새로운 형태의 엘리트주의를 만들어낸다는 점을 지적한다. 그는 AI 시스템이 너무 복잡해 사람들이 이해할 수 없다면, 기술은 대중을 배제하고 ‘전문가 계층’만이 접근권을 갖는 폐쇄적 구조가 된다고 말한다. 따라서 기술의 인간화는 단순성(simplicity)과 해독 가능성(legibility)에서 출발해야 한다.


✒️ 핵심 발췌
? “Simplicity is the key to humanity in technology. If we cannot explain, in human terms, how a data-driven system works, then we risk losing not just control, but also the public's essential trust. The true challenge of machine thinking is making its thought process legible.” (p. 148)
✍️ “단순함은 기술 속 인간성에 이르는 열쇠이다. 만약 우리가 데이터 주도 시스템의 작동 방식을 인간적인 언어로 설명할 수 없다면, 우리는 통제권뿐 아니라 대중의 신뢰까지 잃게 된다. 기계적 사고의 진정한 과제는 그 사고 과정을 해독 가능하게 만드는 것이다.”
➡️ Maeda는 기술의 복잡성이 민주주의를 약화시킬 위험을 경고하며, ‘설명 가능성(Explainability)’의 철학적 의미를 재조명한다.


Maeda의 주장은 기술 비판 담론의 핵심을 찌른다. AI가 아무리 강력해도, 인간이 그 원리를 이해할 수 없다면 기술은 인간을 돕는 도구가 아니라 인간을 지배하는 구조가 될 수 있다. 기술의 투명성과 단순성은 단순한 사용자 편의가 아니라, 인간의 자유와 신뢰를 지키는 민주적 조건이다.


마지막으로 Refik Anadol은 데이터와 기술의 관계를 ‘창조성’의 영역으로 확장시킨다. 그는 데이터를 “우주의 기억”으로 표현하며, AI를 인간 창작자의 지능을 확장하는 파트너로 기능한다고 말한다. 그의 작업은 기술이 인간의 역할을 대체하는 것이 아니라, 인간의 상상력과 감각을 확장하여 새로운 예술적 지평을 열 수 있음을 보여준다.


✒️ 핵심 발췌
? “AI is not here to replace the artist, but to offer a new medium, a new type of canvas made of data. It is a partnership where human intention guides the algorithm's vast capability to remix and reimagine the world's information. Data becomes the paint, and the algorithm the brush.” (p. 154)
✍️ “AI는 예술가를 대체하기 위해 존재하는 것이 아니라, 데이터로 만들어진 새로운 매체, 새로운 유형의 캔버스를 제공하기 위해 존재한다. 그것은 인간의 의도가 알고리즘의 방대한 재구성 능력을 이끄는 파트너십이다. 데이터는 물감이 되고 알고리즘은 붓이 된다.”
➡️ Anadol은 ‘기계적 사고’를 창조성의 파트너로 재해석하며, 데이터가 예술의 원료가 될 수 있는 새로운 가능성을 제시한다.


Lupi와 Cox는 이 세 인터뷰를 통해 기술이 단순한 계산 도구가 아니라 사회 구조·해석 체계·감각 체계를 재편하는 거대한 문화적 힘임을 명확히 드러낸다. 기술은 인간의 목적과 해석을 통해서만 인간적 가치를 획득하며, 그렇지 않을 경우 기술은 효율성의 논리를 앞세워 인간의 의미·윤리·감정·창의성을 주변화하게 된다.


✨ 해설과 통찰: 하이데거의 기술 존재론과 자동화된 세계의 인간

Chapter 4의 논의는 Martin Heidegger가 말한 기술 존재론과 깊게 연결된다. 하이데거는 기술을 단순한 도구가 아니라 세계를 이해하는 특정한 방식, 즉 ‘드러냄의 방식(a way of revealing)’으로 규정했다. 기술은 세계를 ‘자원(resource)’으로 바라보게 만드는 구조를 갖고 있으며, 이를 “틀 짓기(Enframing)”라고 불렀다. Crawford가 말한 알고리즘의 ‘역사적 유물’이라는 개념은 바로 이 틀 짓기의 현대적 형태이다.


AI는 세상을 끊임없이 측정 가능한 데이터로 변환하며, 인간의 시각·감정·윤리·해석을 ‘효율성’의 기준으로 평가한다. 이는 인간이 세계를 풍부하게 경험하기보다 세계를 최적화된 시스템으로 바라보는 ‘기계적 시선’을 내면화하게 만든다. Maeda가 요구한 단순성과 해독 가능성은 이러한 기술적 틀에 맞서 인간적 의미를 지키기 위한 저항이자, 인간이 기술과 더불어 살아가기 위한 최소한의 철학적 원칙이다.


? 핵심 요약

  • AI는 중립적 도구가 아니라 사회적 권력과 편향을 자동화하는 역사적 시스템이다.

  • 기술의 복잡성은 새로운 엘리트주의를 만들며, ‘설명 가능성’은 기술 민주주의의 핵심 조건이다.

  • 데이터는 창조적 매체가 될 수 있으며, AI는 인간의 의도를 기반으로 한 확장된 창의성의 파트너이다.

  • 기계적 사고는 효율성을 약속하지만, 인간의 가치·맥락·감정을 주변화할 위험을 내포한다.

  • 기술은 인간의 목적을 통해서만 인간적인 의미를 갖는다.


? 사회적·철학적·심리학적 비교

  • 벤담의 공리주의: 효율성을 최우선으로 두는 사고방식은 AI 시스템이 사회적 약자를 희생하여 ‘전체 효용’을 극대화하려는 위험을 초래할 수 있다.

  • 맥루한(McLuhan)의 “미디어는 메시지다”: AI라는 ‘매체’가 그 자체로 강력한 사회적 신호를 만들어내며, 알고리즘의 존재만으로도 인간의 판단을 바꾼다.

  • 자동화 편향(Automation Bias): 인간은 알고리즘을 과신하는 경향이 강하여, 비판적 사고 없이 시스템을 신뢰하게 된다.


? 연결 독서 제안

✔️ Kevin Kelly, The Inevitable — 기술의 필연성과 인간의 적응
✔️ Bernard Stiegler, Technics and Time — 기술이 인간 경험을 재구성하는 방식
✔️ Joseph Weizenbaum, Computer Power and Human Reason — 인간 이성으로 환원할 수 없는 영역의 가치


? 사유를 여는 질문

  1. 당신이 매일 사용하는 알고리즘(유튜브, 인스타그램, 네이버 뉴스)은 당신의 사고를 어떻게 ‘틀 짓고’ 있는가?

  2. 기술이 제시하는 효율성과 인간적 가치가 충돌한다면, 당신은 어떤 기준으로 판단할 것인가?

  3. AI가 창조성을 확장하는 파트너가 되기 위해 인간의 의도는 어떻게 설계되어야 하는가?


Chapter 5. Paint by Numbers | 숫자에 의한 그림: 데이터와 창의성

✅ 장 개요: 데이터는 어떻게 예술의 매체가 되는가?

Chapter 5는 데이터가 단순히 분석과 예측의 영역을 넘어 예술적 창의성의 원료가 될 수 있는지를 탐구하는 장이다. 앞선 네 개의 장이 데이터의 사회적·정치적·윤리적 의미를 해부했다면, 이 마지막 장은 데이터를 인간의 감각과 상상력의 세계로 끌어올리며 전혀 다른 지평을 연다. 저자 Lupi와 Cox는 데이터를 차갑고 객관적인 통계가 아니라, 이야기·정서·패턴·리듬·미학을 담아낼 수 있는 ‘표현 재료’로 바라본다.


이 장에서 인터뷰한 Paola Antonelli, Nico Muhly, Sougwen Chung은 각각 디자인·음악·인간-기계 협력 미술의 영역에서 데이터를 창의적 매체로 실험하며, 데이터가 인간의 감각을 확장하는 방법을 보여준다. 이들은 데이터를 보이지 않는 세계를 감각적 형태로 번역하는 도구, 인간의 정체성을 새로운 방식으로 드러내는 장치, 인간과 기계의 새로운 협업 언어로 재해석한다. Chapter 5는 최종적으로 데이터 휴머니즘이 도달하는 목적지가 ‘데이터의 미학’이라는 사실을 밝힌다.


✒️ 핵심 발췌
? “Design is about bridging the chasm between the abstract and the tangible. Data visualization, at its most effective, is not just about showing the numbers, but about making the invisible complexity of our world palatable and aesthetically meaningful to the public. It is a material for telling human stories.” (p. 178)
✍️ “디자인은 추상적인 것과 유형적인 것 사이의 간극을 연결하는 것이다. 가장 효과적인 데이터 시각화는 단순히 숫자를 보여주는 것이 아니라, 우리 세계의 보이지 않는 복잡성을 대중이 맛볼 수 있고 미적으로 의미 있게 만드는 것이다. 그것은 인간의 이야기를 전달하기 위한 재료이다.”
➡️ Antonelli는 데이터를 단순한 정보의 그릇이 아니라 감각적 이해를 위한 ‘형식’으로 재해석하며, 데이터 시각화가 본질적으로 서사적·미학적 행위임을 강조한다.


Antonelli의 시각은 데이터가 예술의 영역에서 ‘물감’과 같은 재료로 기능할 수 있음을 보여준다. 데이터 시각화는 수치의 나열이 아니라, 보이지 않는 현상을 보이게 하고, 복잡성을 질서화하며, 정보의 구조 속에서 아름다움을 발견하게 한다. 이는 데이터가 인간의 감성에 접근할 때 비로소 ‘언어’로 기능할 수 있다는 Lupi의 철학과 깊게 연결된다.


이어지는 작곡가 Nico Muhly의 인터뷰는 데이터를 ‘음악’으로 재구성한다. 그는 데이터를 구조적 패턴, 리듬, 변주로 바라보며, 음악이 숫자와 규칙을 기반으로 감정적 경험을 창조하듯 데이터도 동일한 과정을 거칠 수 있다고 말한다. 그의 작업은 데이터가 시각적 매체를 넘어 청각적 서사로도 확장될 수 있음을 보여준다.


✒️ 핵심 발췌
? “Data is inherently structured, and structure is the foundation of music. When you take a set of numbers, you are finding patterns, rhythms, and variations—these are the same elements that a composer uses. Data is just raw compositional material waiting to be orchestrated.” (p. 184)
✍️ “데이터는 본질적으로 구조화되어 있으며 구조는 음악의 토대이다. 숫자 집합을 취하면 그 안에서 패턴, 리듬, 변주를 발견하게 되는데, 이는 작곡가가 사용하는 것과 동일한 요소들이다. 데이터는 그저 오케스트레이션되기를 기다리는 작곡 재료일 뿐이다.”
➡️ Muhly는 데이터를 음악의 원초적 구조와 동일한 차원에서 이해하며, 데이터가 하나의 ‘감각적 경험’으로 번역될 수 있음을 증명한다.


Muhly의 접근은 데이터를 ‘해석의 대상’이 아닌 ‘경험의 대상’으로 변환시키며, 데이터의 감각적 잠재력을 극적으로 확장한다. 데이터가 리듬을 가진다는 그의 관점은 데이터를 추상적 개념으로만 이해해 온 기존 사고방식을 완전히 전복한다.


마지막으로 예술가 Sougwen Chung은 인간과 기계의 협업을 기반으로 한 ‘공동 창작(co-creation)’의 세계를 펼친다. 그녀의 작업은 로봇 팔과 AI 시스템이 인간의 손 동작을 실시간으로 읽고 반응하며 그림을 함께 그리는 형태를 취한다. 이는 데이터가 인간의 몸짓을 기계가 해석할 수 있는 ‘언어’로 번역하고, 다시 기계의 움직임이 미적 형태로 되돌아오는 ‘순환적 대화’의 구조다.


✒️ 핵심 발췌
? “My work is a partnership with the machine, where data becomes a bridge between human intuition and algorithmic efficiency. The creative act is no longer singular; it is a negotiated space where human gestures are translated into data points, and the machine's ‘reverberations’ are translated back into aesthetic form.” (p. 192)
✍️ “나의 작업은 기계와의 파트너십이며, 데이터는 인간의 직관과 알고리즘 효율성 사이를 연결하는 다리가 된다. 창조 행위는 더 이상 단일하지 않다. 인간의 몸짓은 데이터 포인트로 번역되고, 기계의 ‘잔향’은 미적 형태로 다시 번역되는 협상의 공간이 된다.”
➡️ Chung은 데이터가 인간-기계 협력의 인터페이스가 되는 과정을 설명하며, 데이터 기반 예술의 미래를 제시한다.


Chung의 사례는 데이터가 예술의 단일 창작 구조를 해체하고, 인간과 머신이 함께 창작하는 ‘확장된 예술 생태계’를 열고 있음을 보여준다. 이때 데이터는 양쪽을 연결하는 핵심 언어이며, 기계적 사고는 인간의 상상력을 제한하는 것이 아니라 오히려 확장하는 역할을 수행한다.


✨ 해설과 통찰: 데이터 미학(Aesthetics of Information)과 인간 감각의 확장

Chapter 5는 데이터를 예술적·감각적 재료로 재정의함으로써 데이터 휴머니즘의 완성을 보여준다. 데이터는 원래 통제·관리·예측의 도구로 사용되어 왔으나, 이 장의 예술가들은 데이터를 감성적 언어로 변환하여 데이터의 탈환(recapture)을 시도한다. 데이터는 감정과 감각의 세계로 들어올 때 비로소 ‘차갑고 추상적인 기호’에서 벗어나 ‘따뜻한 인간적 표현’이 된다.


이는 Walter Benjamin의 “기술 복제 시대의 예술” 논의를 넘어, 데이터 생성 시대의 예술이라는 새로운 차원을 제시한다. 데이터는 끊임없이 조합·생성·변주될 수 있는 비-고정적 매체이며, 예술은 더 이상 작품이 아니라 실시간 프로세스가 된다. 또 Deleuze의 리좀(Rhizome) 개념처럼, 데이터 포인트들은 서로 비선형적으로 연결되며 새로운 의미의 네트워크를 형성한다. 데이터 예술은 바로 이 비선형적 연결을 감각적으로 체험하게 하는 장치다.


? 핵심 요약

  • 데이터는 감각적·미학적 형태로 번역될 수 있는 예술적 재료이다.

  • 데이터 시각화는 보이지 않는 복잡성을 ‘감각 가능한 형태’로 재구성한다.

  • 데이터는 음악적 패턴과 리듬을 담아 청각적 경험을 만들 수 있다.

  • 인간-기계 협업 예술은 데이터를 상호 창작의 언어로 활용한다.

  • 데이터 미학은 데이터 휴머니즘의 가장 창조적이고 인간적인 구현이다.


? 사회적·철학적·심리학적 비교

  • Walter Benjamin, 아우라의 해체: 데이터 예술은 작품 개념을 실시간 프로세스로 전환한다.

  • Deleuze & Guattari의 리좀: 데이터는 비선형적으로 연결되어 새로운 의미를 창출한다.

  • 게슈탈트 심리학: 데이터 시각화는 인간이 정보를 ‘전체적 형태’로 인식하게 만든다.


? 연결 독서 제안

✔️ John Maeda, The Laws of Simplicity — 인간 중심 데이터 미학
✔️ Rudolf Arnheim, Art and Visual Perception — 시각적 형태의 심리학
✔️ James Gleick, The Information — 정보철학과 데이터의 역사


? 사유를 여는 질문

  1. 당신의 일상 데이터(수면·운동·검색 기록)를 예술 작품으로 표현한다면 어떤 서사가 만들어질까?

  2. AI와 인간의 공동 창작에서 ‘원작자’의 개념은 어떻게 재정의되어야 할까?

  3. 데이터 아트는 데이터 리터러시를 넘어 감성적 공감 능력을 확장하는 도구가 될 수 있을까?


? 결론 | 데이터 휴머니즘의 완성: 숫자를 넘어 인간의 언어로

Speak Data의 마지막 페이지를 덮을 때, 독자는 이전까지 ‘객관적 사실’이라고만 여겨왔던 데이터가 실제로는 인간의 욕망·권력·감정·창의성이 투영된 깊은 문화적 산물임을 깨닫게 된다. Giorgia Lupi와 Phillip Cox는 이 책에서 데이터를 단순한 정보의 조각이 아니라, 인간이 세계를 이해하고 스스로를 서술하는 하나의 언어로 제시한다. 데이터는 진실을 복원하는 도구가 아니라 진실을 구성하는 방식, 즉 인간 경험을 번역하고 재조합하는 서사적 매체다. 이 책이 말하는 “Speak Data”는 데이터가 우리에게 말을 거는 것이 아니라, 우리가 데이터를 통해 우리의 삶을 말하게 되는 순간을 의미한다.


오늘날 데이터는 사회적 권력의 구조를 반영하며, 개인의 정체성을 재편하고, 우리의 건강과 감정과 관계를 형성하며, 알고리즘을 통해 사고 체계를 재구성하고, 나아가 예술적 감각의 새로운 지평을 연다. 데이터는 단일한 실체가 아니라, 정체성(identity), 소통(communication), 건강(health), 기술(technology), 창조성(creativity)이라는 인간 경험의 다섯 개 층위를 관통하며 살아 움직인다. 이 책의 핵심 메시지는 바로 여기에 있다. 데이터는 인간을 이해하기 위한 도구가 아니라, 인간이 데이터를 통해 스스로를 다시 정의하는 새로운 문법이라는 것이다.


? 현대적 의미와 적용

1) 데이터의 탈환(Recapture): 감시의 언어에서 자기 표현의 언어로

데이터는 그동안 기업·국가·플랫폼이 사람을 예측하고 통제하기 위한 장치로 사용되어 왔다. 그러나 Speak Data는 데이터를 인간의 손으로 되돌려 놓는 방법을 보여준다. 정체성을 측정하는 대신 ‘정체성을 서술하는 데이터’, 건강을 감시하는 대신 ‘건강 서사를 공동 집필하는 데이터’, 기술에 종속되는 대신 ‘기술을 재해석하는 인간적 목적’, 예측이 아니라 ‘표현’의 차원에서 데이터를 새롭게 활용하는 시도는 데이터의 주체를 다시 인간에게 돌려준다. 이것이 데이터 휴머니즘의 본질이다.


2) 알고리즘 윤리의 재정립: 설명 가능성과 포괄성을 기준으로

AI 시대에 데이터는 단순한 기술적 문제를 넘어 사회 정의의 문제로 이동했다. Speak Data는 알고리즘의 편향, 데이터 공백, 의료 AI의 블랙박스, 사회적 분류 체계가 재생산하는 불평등 등 데이터가 인간의 삶에 미치는 윤리적 문제를 세밀하게 다룬다. 그리고 이를 해결하기 위한 핵심 원칙은 두 가지다.

  • 설명 가능성(Explainability): AI가 무엇을 판단했는지가 아니라, 왜 그렇게 판단했는지 설명할 수 있어야 한다.

  • 포괄성(Inclusiveness): 데이터가 대표하지 못한 집단을 배제하지 않고 반영하는 일이 기술적 정확성 못지않게 중요하다.
    이 두 원칙은 기술의 인간화를 위한 새로운 윤리적 토대다.


3) 창의성의 확장: 데이터의 미학과 인간-기계 협업

데이터는 감정·리듬·형태·색채·움직임을 담아낼 수 있는 창조적 매체다. 예술가들은 데이터를 음악으로 번역하고, 시각적 패턴으로 재조합하고, 인간의 직관과 기계의 계산을 결합해 새로운 형태의 예술을 창조한다. 이는 데이터를 분석의 도구로만 보는 시각에서 벗어나 데이터를 경험의 매체, 미학의 재료, 그리고 창작의 언어로 재정의한다. 미래의 창의성은 인간의 직관과 알고리즘의 재구성 능력이 만나는 지점에서 확장될 것이다.


4) 비판적 데이터 리터러시: 데이터 해독 능력은 현대 시민의 교양

데이터는 언제나 ‘편집된 이야기’이며, 중립적 차트는 존재하지 않는다. 따라서 데이터의 논증 구조, 감정적 연출, 생략된 정보, 역사적 맥락, 제시 의도 등을 해석하는 능력—즉, 비판적 데이터 리터러시(Critical Data Literacy)—는 현대 사회를 이해하고 민주적 판단을 내리기 위한 필수 지적 능력이다.


? 누구에게 이 책을 추천하는가?

● 데이터를 다루는 모든 실무자에게

디자이너, 분석가, 엔지니어, AI 연구자, 마케터 등 데이터를 읽고 시각화하고 설계하고 전달하는 업무를 수행하는 사람들에게 이 책은 ‘기술 이면의 철학’을 제공한다.

● 커뮤니케이션·미디어·정책 종사자에게

숫자로 대중을 설득하는 시대에 필요한 윤리적 기준, 수사적 구성, 책임 있는 소통 철학을 배우는 데 적합하다.

● 철학·인문·사회과학 분야 연구자에게

데이터가 인간의 정체성·감정·행동·권력·창작을 어떻게 재구성하는지 탐구하기 위해 훌륭한 사유의 기반을 제공한다.

● 현대의 데이터 환경에 능동적으로 참여하고자 하는 모든 독자에게

데이터 시대를 수동적으로 소비하지 않고 능동적으로 ‘읽고, 쓰고, 말하고, 창작하고, 저항’하고 싶은 사람들에게 이 책은 강력한 지적 도구다.


? 이 책이 던지는 핵심 질문들

❓ 1) 데이터가 당신의 정체성·감정·건강을 정량화할 때, ‘측정 불가능하기 때문에 더 소중한 것’은 무엇인가?

❓ 2) 데이터가 설득의 무기이자 선동의 도구가 될 수 있는 시대에, 당신은 데이터를 어떤 기준으로 읽고 질문할 것인가?

❓ 3) AI라는 기계적 사고가 세계를 재구성하는 시대에, 당신은 기술을 어떻게 ‘인간적 목적’에 맞게 재설계할 것인가?

❓ 4) 데이터를 예술적 재료로 다룰 수 있을 때, 데이터는 당신의 삶에 어떤 새로운 의미를 부여할 수 있을까?


#데이터휴머니즘 #SpeakData #GiorgiaLupi #데이터리터러시 #데이터시각화 #AI윤리 #데이터와정체성 #기계적사고 #데이터아트 #창의성과데이터 #빅데이터사회 #알고리즘권력 #인문학적통찰 #데이터비평 #정보의미학